退出 Agent Babysitting:程序管对错,人只开最高代价闸门
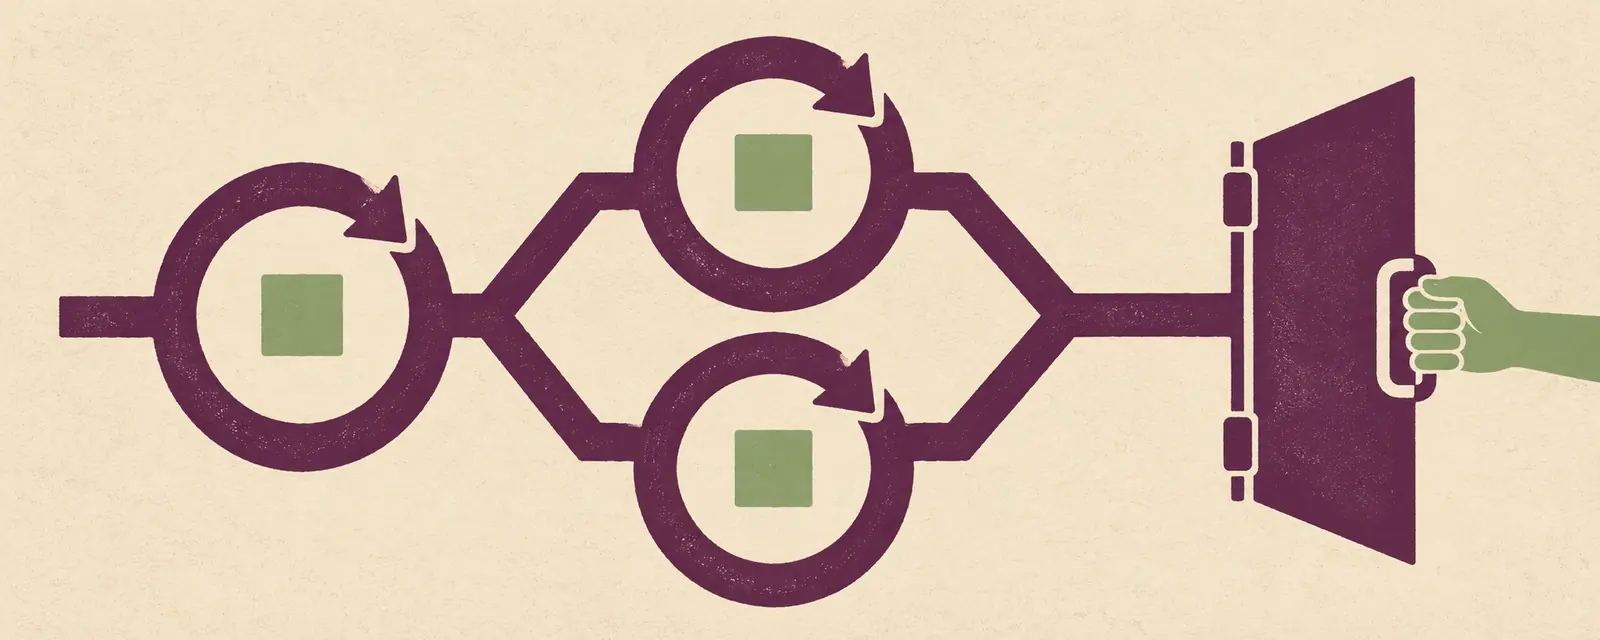
人盯每一步不是因为模型能力弱,而是系统只建了半套:先写程序可判定的失败条件让 Loop 自动改错,再画工作图把关拆分与并行;闸门按撤销代价分级,人只守在不可逆的终点。
用过 AI agent 的工程师常有一种体会:本想让 agent 分担工作,却得像监考一样盯紧它的每一步输出。视线移开一会儿,它可能就在循环里反复试错、改动不该动的基础配置,或者输出看起来很自信但测试实际没过。
这种状态常被称为「agent babysitting」(当 agent 的保姆)。容易想到的解释是模型推理能力还不够,等下一代模型发布就能省心。但近期的多篇工程复盘指向了另一个方向:人之所以要盯住每一步,往往不是因为模型弱,而是外围系统只建了半套。 要么只有一个线性循环(Loop),缺乏拓扑与流向管理(Graph);要么画了流程图,却没有能大声失败的客观检查。
之前在 Agent Harness 是 AI 时代的操作系统层 和 Agent Loop 的核心是触发条件、停止条件和验证标准 中,我讨论过单 agent 外围的环境与循环设计。若要把多 agent 用进日常工程,核心在于把人从常规巡检中撤出来:让程序管理对错,人只守在撤销代价最高的那一道闸门前。
Loop 管单元做对:检查必须先于工作,且必须能失败
让 agent 在无人盯防时把事情做对,基础构件是循环(Loop)。如 Hanako(@hanakoxbt)所总结,Loop 的核心是闭环状态机:生成(produce) → 检查(check) → 纠错(correct) → 直到变绿。很多系统在第一步就卡住了——它们缺少合格的「检查」。
常见的误区是让另一个模型看看写得好不好,同级 LLM 互评往往只是互相认同;另一个误区是没报错就算成功,但没有显式错误并不等于逻辑正确。在缺少明确失败条件的循环里,Loop 只会把错误反复执行,直到耗尽上下文或预算。合格的检查通常需要满足两个条件:
- 程序可判定:测试退出码为 0、类型检查通过、diff 仅触碰声明范围内的文件、报告里的数据附带环境出处。
- 必须能够失败:检查强度取决于它所接受的最弱证据。自报「没问题」没有成本,一项从来不会变红的检查起不到把关作用。
但即使单元循环运转良好,Loop 也只负责让单个单元变绿,管不了整体的结构与方向。 如果任务一开始就拆错了维度,或者把本可以并行的工作串联起来,哪怕每个节点都在各自的循环里顺利通过,整套系统依然会很慢,产出的结构也容易变形。这种问题不在单元内部,微调 Loop 很难解决。
Graph 管拓扑与流向:教训写回结构,不写回 prompt 劝诫
管理宏观结构的是图(Graph)。Graph 处在节点之间,负责任务拆分(splitter)、并行分发(worker)、确定性转换(code node)以及汇聚闸门(gate)。搭建 Graph 时,有几条比较实用的工程经验:
第一,节点类型保持分离。不需要模型推理的转换(正则提取、格式转换、字段过滤、代码编译),尽量写成确定性代码节点(code node),不为基础数据处理支付模型开销。负责推理的工作节点(worker)则分配独立的上下文,避免多个 worker 共享上下文后互相干扰,收敛成单一意见。
第二,区分两条回流边。系统里通常需要两种反馈机制:短边负责把当前轮次的报错喂回本单元做局部重试;长边则在某个切片多次失败或暴露前置假设问题时,提炼出结构化约束,写回上游的任务模板或拆分规则。退回应尽量限定在出错的单元内,整批打回容易打乱已经验证正确的部分。
第三,教训写回出错那一层的结构,不写回 prompt 劝诫。发现 agent 误改了数据库迁移目录,常见做法是在提示词里加粗提醒不要改动该目录。但正如 m4lka(@m4lkxx)所提醒的,愿望不等于墙;Yarchi(@undefinedKi)在七层岗位设计里也强调,指令只是愿望,权限边界才是护栏。Lunar(@LunarResearcher)的对应做法,是把指令下沉为环境检查与环外策略。模型下一次仍可能因注意力漂移而违规,更稳妥的做法是在工具网关与文件沙箱层直接移除该目录的写入权限,把教训沉淀成结构约束。
闸门按撤销代价分级:人只站在不可逆的终点
减少盯梢并不是放任不管,而是按动作的撤销代价(undo cost)与爆炸半径建立分级机制,不依赖模型容易浮夸的自信度:
- 低代价/可逆动作:修改单个代码文件、跑本地测试、生成草稿。这类操作出错后容易用版本控制回滚,可以直接自动放行。
- 中等代价/局部影响:公共模块重构、依赖调整、提交 PR。这类操作通常要求确定性测试通过且执行链路(trace)符合规范,自动进入待审队列。
- 高代价/不可逆动作:数据库结构迁移、删除线上数据、对外发送邮件、涉及资金的操作。这类车道在系统底层应默认关闭自动通行,无论模型自评得分多高,最后一步都要等人来确认。
支撑检查与闸门的是评测(Evals)。如果一开始就直接让大模型当打分法官,给出 1 到 5 分的综合评价,看到 95% 就上线,在实际场景中往往容易漏掉问题。anshul(@luhsnaa)总结过较为理性的步骤:
- 先读 100 条左右的真实 trace,对实际失败的原因建立直接了解;
- 剔除不影响系统决策的微小失败,多数细碎杂音不需要专门写 eval;
- 把核心失败模式二元化,写成代码级的 pass/fail 检查;
- 整理基准数据集,区分「能力集」(用来探索边界,可以通过率在 70% 左右)与「回归集」(用来防退步,应接近 100%);
- 自动化法官放在后面,并用真正例率(TPR)与真负例率(TNR)校验其判断。对于要求每次都做对的关键任务,重点看连续通过的
pass^k,避免被单次偶中的pass@1误导。
我自己的小规模版本
日常维护 perryOS 时,我把这些思考收敛成了几条具体习惯:
- 主 agent 负责拆分与验收:主要负责拆解任务、派发给执行方、合并改动与最终验收,不直接写业务代码,避免上下文被细碎代码填满。
- 子 agent 不碰版本历史:子 agent 不执行
git add和git commit。提交到版本历史是更高代价的动作,这项闸门由主 agent 在外层统一把守,子 agent 只在工作区修改文件。 - 用系统证据验收,不陪看过程:验收时不逐屏去读调试日志,也不比对每张截图,而是直接读取
git diff确认改动范围受限,并在集成时跑一次全量测试、类型检查和代码风格检查。编译器和测试的退出码比模型的自我汇报更可靠。 - 防范虚假完成:看到终端状态显示 done 时,不能直接当成做完了,有时只是等待工具调用的中间停顿。接手前先读最后的输出,确认任务确实交付了。
我还不确定的地方
这套让程序管单元对错、图管拓扑、人只看不可逆闸门的方式在逻辑上很清楚,但实际使用时仍有些难点:
一是可逆性边界的判定。现代工程里隐式依赖很多,有些改动看似只调了前端样式,若不经意改了全局状态的计算逻辑或增加了接口请求频率,可能在特定流量下引发下游限流。自动化检查要细致到什么程度,才能在不过度拦截的同时防住这类隐性问题?
二是投入产出比的平衡。画出完整的 Graph、编写配套的确定性测试、维护一套高通过率的回归集,前期需要花不少精力。对于生命周期只有几天的小工具或探索性脚本,建这套机制的时间可能比自己盯几遍还要长,在什么规模下切入最划算,我还在摸索。
接下来想弄清楚的问题
- 如何让编写功能的 agent 在较少人工干预下,自动为具体任务生成高质量、客观的验收测试,同时避免测试逻辑本身出现幻觉?
- 随着长期约束沉淀到 Graph 的规则与模板中,当下游模型版本更新后,怎样及时识别并删去那些已经过时的防御性规则(harness decay)?
- 当多个并行的子 agent 在各自环境中把单元改好后,多路合并时的逻辑冲突,是否能通过规则更自动地仲裁?
参考
- 《Loops and Graphs: how to stop babysitting agents and only approve the last step (full course)》:Hanako(@hanakoxbt)发表于 X,2026 年 8 月 23 日。提出减少盯梢的关键是拆分 Loop(节点内循环纠错至变绿)与 Graph(节点间任务编排、拆分、并行与回流),强调检查须程序可判定且能失败,人守在合并与上线的关键闸门。
- 《Harness, Loops, Graphs: What Each Layer Fixes and What It Breaks》:m4lka(@m4lkxx)发表于 X,2026 年 10 月 25 日。论证 Harness、Loop、Graph 是自下而上的递进阶梯,提出检查强度取决于所接受的最弱证据,愿望不等于墙,闸门按撤销代价分级,教训应沉淀到出错层的结构里。
- 《Harness Engineering: The Complete Guide to Building AI Agents That Don't Fall Apart》:Lunar(@LunarResearcher)发表于 X,2026 年 9 月 6 日。系统梳理 Harness 工程体系,提出模型负责推理而 harness 负责结构,强调前置任务契约、工具网关校验、环境证据优先及把指令下沉为检查和策略。
- 《How to Build a Production AI Agent: The 7 Layers Between the Model and the Result (Full Guide)》:Yarchi(@undefinedKi)发表于 X,2026 年 10 月 30 日。提出生产级 Agent 七层设计模型,论证指令只是愿望而权限边界才是护栏,自主权按动作危险程度授予,对外发信、删数据与资金动作由人工把关。
- 《everything you need to know about agent EVALS》:anshul(@luhsnaa)发表于 X,2026 年 11 月 1 日。给出构建 agent evals 的实用路径:亲读 trace、消除无效失败、二元化代码检查到黄金数据集(能力集与回归集拆分),指出自动化 LLM judge 排在后面,关键任务须考核 pass^k 指标。